Llama : l'IA locale de llama.cpp sans ligne de commande
L'IA locale sur Windows 11 : une révolution silencieuse
Pendant longtemps, faire tourner un modèle de langage open source sur son propre ordinateur relevait de l'exploit réservé aux développeurs et aux bidouilleurs du dimanche. Il fallait ouvrir un terminal, maîtriser Python, installer des dépendances complexes via des gestionnaires de paquets obscurs, et prier pour que l'accélération matérielle fonctionne correctement. Cette époque est en train de s'achever. L'équipe derrière le célèbre moteur d'inférence llama.cpp a franchi un nouveau cap en proposant une application native pour Windows 11, aboutissant ainsi à Llama - L'IA locale de llama.cpp, sans ligne de commande. Cette transition d'un outil en ligne de commande vers une interface graphique intégrée au système d'exploitation marque une étape cruciale dans la démocratisation de l'intelligence artificielle.
Imaginez un scénario classique : un rédacteur web souhaite utiliser une IA pour générer des brouillons d'articles, mais son entreprise interdit l'envoi de données confidentielles vers les serveurs d'OpenAI ou de Google. Jusqu'à présent, la solution de secours consistait à utiliser des outils tiers plus ou moins stables. Aujourd'hui, l'équipe de llama.cpp offre une alternative officielle, élégante et directement intégrée à l'environnement Windows. Cette application permet de télécharger, de configurer et de discuter avec des modèles de langage localement, sans qu'une seule donnée ne quitte votre machine. Chez Studio Dahu, nous observons attentivement cette évolution, car elle s'inscrit parfaitement dans la tendance de la privacy-first et de l'IA & Automatisation à Genève.
Découvrir l'application Llama : l'IA locale de llama.cpp, sans ligne de commande
L'application Llama n'est pas une simple surcouche disgracieuse posée sur un moteur en C++. Il s'agit d'une application Windows native, pensée pour s'intégrer harmonieusement dans l'écosystème de Microsoft. Le concept est audacieux mais redoutablement efficace : faire disparaître la complexité technique au profit d'une expérience utilisateur fluide et immédiate. Fini les scripts bash et les erreurs de compilation, place à la souris et au clavier.
Une intégration profonde dans Windows 11
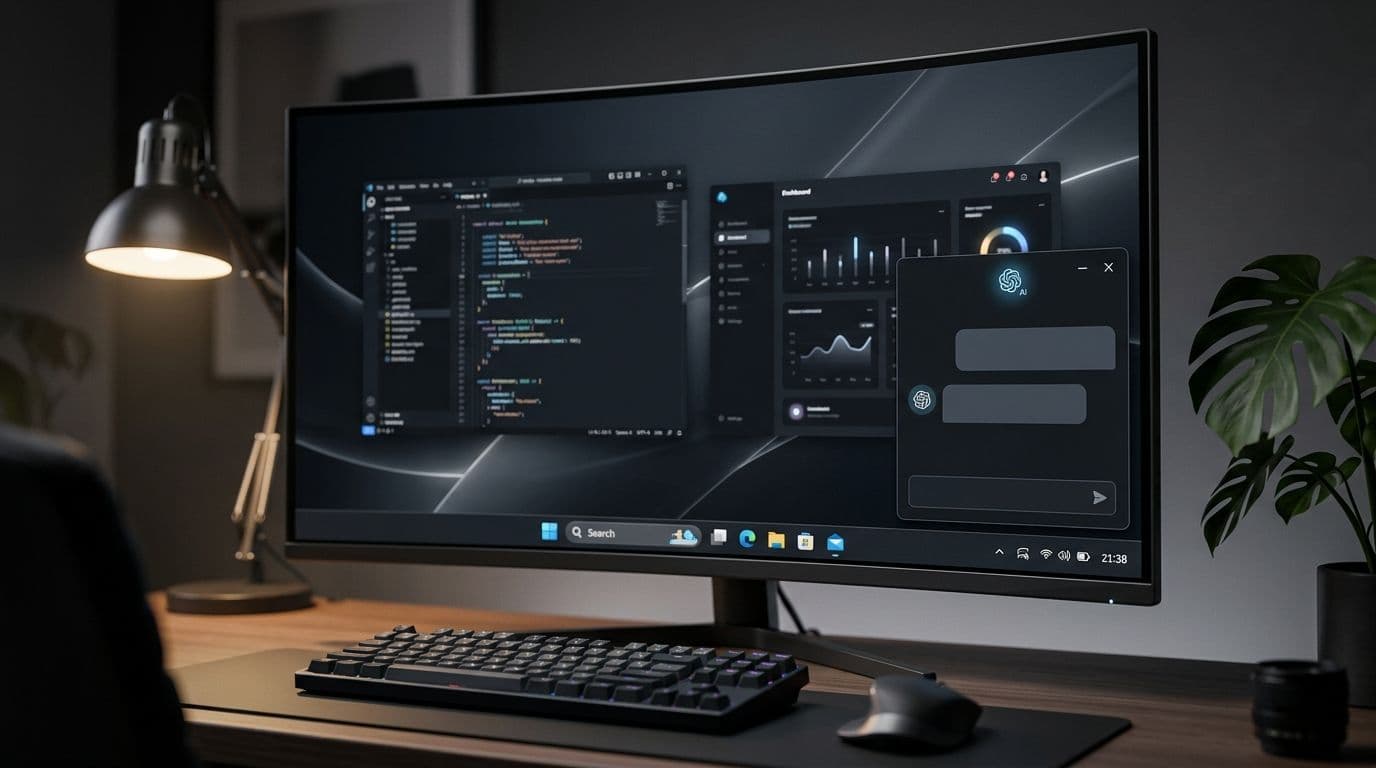
Dès son installation, l'application se fait discrète. Elle ne s'étale pas sur votre bureau avec des fenêtres envahissantes, mais vient se loger intelligemment dans la zone de notification, à côté de l'horloge système. Cette zone, souvent sous-exploitée par les applications modernes, devient ici le centre de contrôle de votre intelligence artificielle locale. Un simple clic sur l'icône permet d'accéder aux paramètres, de surveiller l'utilisation de la mémoire ou de changer de modèle de langage à la volée. Cette approche pragmatique rappelle que les meilleures technologies sont souvent celles qui se font oublier.
Le raccourci Alt+Espace pour un chat instantané
La véritable magie de cette application opère lorsque vous appuyez sur la combinaison de touches Alt+Espace. Instantanément, une fenêtre de chat compacte et élégante apparaît à l'écran, superposée à vos applications en cours. Vous pouvez lui poser une question, lui demander de résumer un texte copié dans le presse-papiers, ou générer un bout de code, puis la fenêtre se referme aussitôt. Cette interaction par raccourci clavier transforme radicalement le flux de travail. L'IA n'est plus une destination vers laquelle il faut se rendre en ouvrant un navigateur ou un IDE, mais un compagnon omniprésent, invoqué à la demande. C'est exactement le type de fluidité que nous recherchons lors de nos développements sur mesure à Genève pour nos clients.
Astuce de pro : Le raccourci Alt+Espace est conçu pour une utilisation frictionless. Habituez-vous à l'utiliser pendant vos tâches de rédaction ou de code. Le temps économisé sur les bascules entre fenêtres peut représenter plusieurs heures par semaine.
Le téléchargement des modèles GGUF simplifié
Si l'interface de chat est séduisante, le véritable cauchemar de l'IA locale a toujours été la gestion des modèles. Les fichiers GGUF (GPT-Generated Unified Format), qui compressent les poids des réseaux de neurones pour qu'ils puissent tourner sur des machines standards, sont volumineux. Troucher le bon modèle, s'assurer de sa compatibilité avec sa version de llama.cpp, et le placer dans le bon dossier du disque dur était une tâche rébarbative. L'application Llama resolout ce problème avec brio en intégrant un gestionnaire de téléchargement directement dans son interface.
Depuis le menu de la zone de notification, l'utilisateur peut naviguer dans une bibliothèque curée de modèles. Imaginez une liste où vous sélectionnez simplement la taille du modèle (par exemple, 7B ou 8B pour des ordinateurs avec 16 Go de RAM) et son architecture (Llama 3, Mistral, Phi-3). L'application gère le téléchargement en arrière-plan, vérifie l'intégrité du fichier, et l'ajoute automatiquement à la liste des modèles disponibles. Cette automatisation élimine l'une des plus grandes barrières à l'entrée pour les non-techniciens.
- Sélection simplifiée : Choisissez le modèle selon les capacités de votre PC.
- Téléchargement sécurisé : Vérification automatique des hashes pour éviter les fichiers corrompus.
- Changement à la volée : Passez d'un modèle léger pour de la génération rapide à un modèle plus lourd pour de la logique complexe en un clic.
Les deux limites qui font coincer l'application
Aucune solution technologique n'est parfaite, et l'application Llama ne fait pas exception à la règle. Bien qu'elle représente un bond en avant spectaculaire pour l'accessibilité de l'IA locale, elle comporte deux limitations majeures qui peuvent frustrer l'utilisateur, particulièrement dans des contextes d'entreprise ou de sécurité avancée. Il est crucial d'avoir ces contraintes en tête avant de déployer l'outil.
Un raccourci clavier immuable
La première frustration vient du raccourci Alt+Espace. Si ce combo est idéalement placé pour un accès rapide, il s'avère être non modifiable dans les paramètres actuels de l'application. C'est une décision de conception (UX design) qui peut paraître anodine, mais qui pose de réels problèmes d'ergonomie. De nombreuses applications professionnelles utilisent déjà Alt+Espace pour ouvrir le menu système des fenêtres Windows (celui qui permet de restaurer, déplacer ou fermer une fenêtre). Ce conflit de raccourcis crée une friction cognitive : l'utilisateur doit reprogrammer sa mémoire musculaire, ce qui n'est jamais une bonne pratique en expérience utilisateur. Une mise à jour future permettra peut-être de personnaliser ce déclencheur, mais en attendant, il faudra s'adapter.
Le blocage par Smart App Control
La seconde limite est bien plus problématique pour les entreprises soucieuses de leur sécurité informatique. Windows 11 intègre une fonctionnalité de sécurité nommée Smart App Control (SAC). Ce dispositif bloque par défaut l'exécution d'applications non signées numériquement ou jugées potentiellement dangereuses par le cloud de Microsoft. Actuellement, l'application Llama de llama.cpp se heurte à ce filtre. Si le Smart App Control est activé sur votre machine, l'installation ou le lancement de l'application sera tout simplement interdit.
Pour contourner ce problème, un administrateur système doit soit désactiver le Smart App Control (ce qui dégrade la posture de sécurité globale de la machine et est irréversible sans réinitialisation de Windows), soit trouver un moyen d'ajouter l'application à une liste d'exceptions, si tant est que l'éditeur ait fourni une signature numérique valide. C'est le dilemme classique entre l'adoption rapide d'outils open source innovants et le maintien d'une politique de cybersécurité stricte.
Leçon de l'expert : En environnement d'entreprise, ne demandez jamais à vos employés de désactiver des sécurités système comme le Smart App Control pour faire tourner une IA locale. Privilégiez des conteneurs Docker ou des solutions validées par votre service IT.
Pourquoi l'IA locale change la donne pour les entreprises
Au-delà des prouesses techniques de llama.cpp, c'est la philosophie sous-jacente de l'IA locale qui interpelle les professionnels. Le modèle économique des IA cloud, basé sur le paiement au token ou par abonnement, devient de plus en plus coûteux à mesure que l'utilisation s'intensifie. L'IA locale propose un paradigme inverse : un coût initial (l'achat d'une machine performante) suivi d'un coût marginal quasi nul. Chaque mot généré par le modèle Llama 3 tournant sur votre PC est totalement gratuit.
Imaginez une fiduciaire qui souhaite automatiser l'extraction de données à partir de centaines de factures reçues par mail. Envoyer ces documents sensibles à une API externe pose un risque de confidentialité majeur. En utilisant un modèle local via une interface adaptée, le traitement se fait en vase clos. C'est dans cette optique de confidentialité absolue que nous structurons nos offres de création de site internet pour fiduciaire à Genève, où la protection des données client est non négociable.
De plus, la disponibilité de l'IA locale est totale. Pas de coupure de réseau, pas de serveur surchargé en fin de journée, pas de déprécation soudaine d'un modèle (comme c'est souvent le cas avec les API commerciales qui forcent la migration vers de nouvelles versions). L'application Llama de Windows 11 vous donne le contrôle total sur votre cycle de vie logiciel. Si une mise à jour de l'application vous déplaît, vous gardez l'ancienne version. C'est une forme de souveraineté numérique qui n'a pas de prix dans un monde où les géants de la tech dictent leurs règles.
Configurer son environnement pour une performance optimale
Pour que Llama - L'IA locale de llama.cpp, sans ligne de commande fonctionne de manière fluide, quelques précautions matérielles s'imposent. L'inférence d'un modèle de langage est une tâche extrêmement gourmande en ressources. Si l'application masque la complexité du code, elle ne peut pas inventer de puissance matérielle inexistante.
Le rôle crucial de la RAM et du VRAM
Le facteur limitant numéro un pour l'IA locale est la mémoire. Un modèle de 8 milliards de paramètres (comme Llama 3 8B) nécessite environ 6 à 8 Go de mémoire vive pour être chargé en format GGUF Q4 (quantification 4-bit). Si vous utilisez le processeur (CPU) pour les calculs, votre ordinateur doit avoir au moins 16 Go de RAM au total pour éviter que le système d'exploitation ne commence à utiliser le disque dur comme mémoire virtuelle (ce qui diviserait la vitesse d'inférence par dix).
Cependant, la véritable magie opère lorsque vous avez une carte graphique dédiée (GPU) avec suffisamment de VRAM. L'application Llama gère nativement l'accélération matérielle via CUDA (pour les cartes Nvidia) ou Vulkan/OpenCL (pour AMD). En transférant les calculs vers le GPU, on obtient des vitesses de génération de texte qui rivalisent avec les services cloud. L'idéal reste un PC avec 32 Go de RAM et une carte graphique possédant au moins 12 Go de VRAM, permettant de faire tourner des modèles plus puissants (comme Llama 3 70B en version ultra-quantifiée) pour des tâches demandant un raisonnement complexe.
L'avenir de l'IA générative sur le poste de travail
La sortie de cette application par l'équipe de llama.cpp n'est pas un fait isolé, c'est l'annonce d'une tendance lourde. Les systèmes d'exploitation vont progressivement intégrer des modèles d'IA localement, au même titre que des pilotes d'imprimante ou des codecs vidéo. Apple l'a déjà initié avec Apple Intelligence sur ses puces M-series, et Microsoft prépare sa propre vague avec Copilot+ PC et le NPU (Neural Processing Unit) intégré.
Cependant, l'approche open source de llama.cpp offre une flexibilité que les solutions propriétaires ne peuvent égaler. Vous n'êtes pas limité à un seul modèle fourni par le fabricant du système d'exploitation. Demain, si un nouveau modèle open source plus performant sort (que ce soit de Mistral, Meta, ou Alibaba), vous pourrez le télécharger au format GGUF et le brancher immédiatement dans l'application. Cette agilité est un atout majeur pour les développeurs et les entreprises innovantes. C'est pourquoi nous suivre via la Newsletter Studio Dahu est essentiel pour rester informé de ces avancées techniques qui redéfinissent le paysage numérique.
Analyse de tendance : L'IA locale ne va pas tuer l'IA cloud. Les deux vont coexister. Le cloud pour la puissance de calcul extrême (l'entraînement et l'inférence de modèles géants de 400B+ paramètres), et le local pour la confidentialité, la réactivité et les tâches quotidiennes sans dépendance réseau.
En conclusion, l'arrivée d'une interface graphique officielle pour llama.cpp sur Windows 11 abat l'une des dernières barrières qui séparait le grand public de l'intelligence artificielle souveraine. En dépit de défauts de jeunesse comme le raccourci immuable ou le conflit avec le Smart App Control, l'application Llama démontre que l'inférence locale est désormais mature, accessible et prête à être intégrée dans les flux de travail de tous les jours.
Questions fréquentes
Qu'est-ce que l'application Llama pour Windows 11 ?
C'est une interface graphique officielle développée par l'équipe de llama.cpp, permettant de télécharger et d'utiliser des modèles d'IA localement, sans passer par un terminal ou des lignes de commande complexes.
Comment lance-t-on le chat local avec l'application Llama ?
Le chat local s'ouvre grâce au raccourci clavier Alt+Espace. Cette fenêtre compacte permet d'interagir instantanément avec votre modèle de langage, par-dessus vos autres applications.
L'application Llama est-elle gratuite ?
Oui, l'application et le moteur llama.cpp sont open source et gratuits. Cependant, vous devez disposer d'un ordinateur suffisamment puissant (beaucoup de RAM et idéalement un GPU dédié) pour faire tourner les modèles confortablement.
Que faire si l'application est bloquée par Smart App Control ?
Si Windows 11 bloque l'application via Smart App Control, vous devez soit désactiver cette fonctionnalité (ce qui est déconseillé pour la sécurité), soit attendre une mise à jour de l'application offrant une signature numérique reconnue par Microsoft.
Où l'application télécharge-t-elle les modèles GGUF ?
L'application intègre un gestionnaire de téléchargements accessible depuis la zone de notification. Il permet de choisir et de télécharger automatiquement les fichiers GGUF des modèles (comme Llama 3 ou Mistral) directement depuis les serveurs officiels comme Hugging Face.